
KELVIN Meridian
Lernt aus einer Erfahrung. Antwortet aus dem Behaltenen. Sagt es, wenn ihm nie etwas gesagt wurde.
Ihre Programme fragen KELVIN direkt, mit einem eigenen Schlüssel. Es braucht keinen Trainingslauf und keine Grafikkarte, und was es lernt, bleibt bei ihm: Eine Anfrage trägt nur die Frage.
Eine erinnerte Antwort
8,7 ms
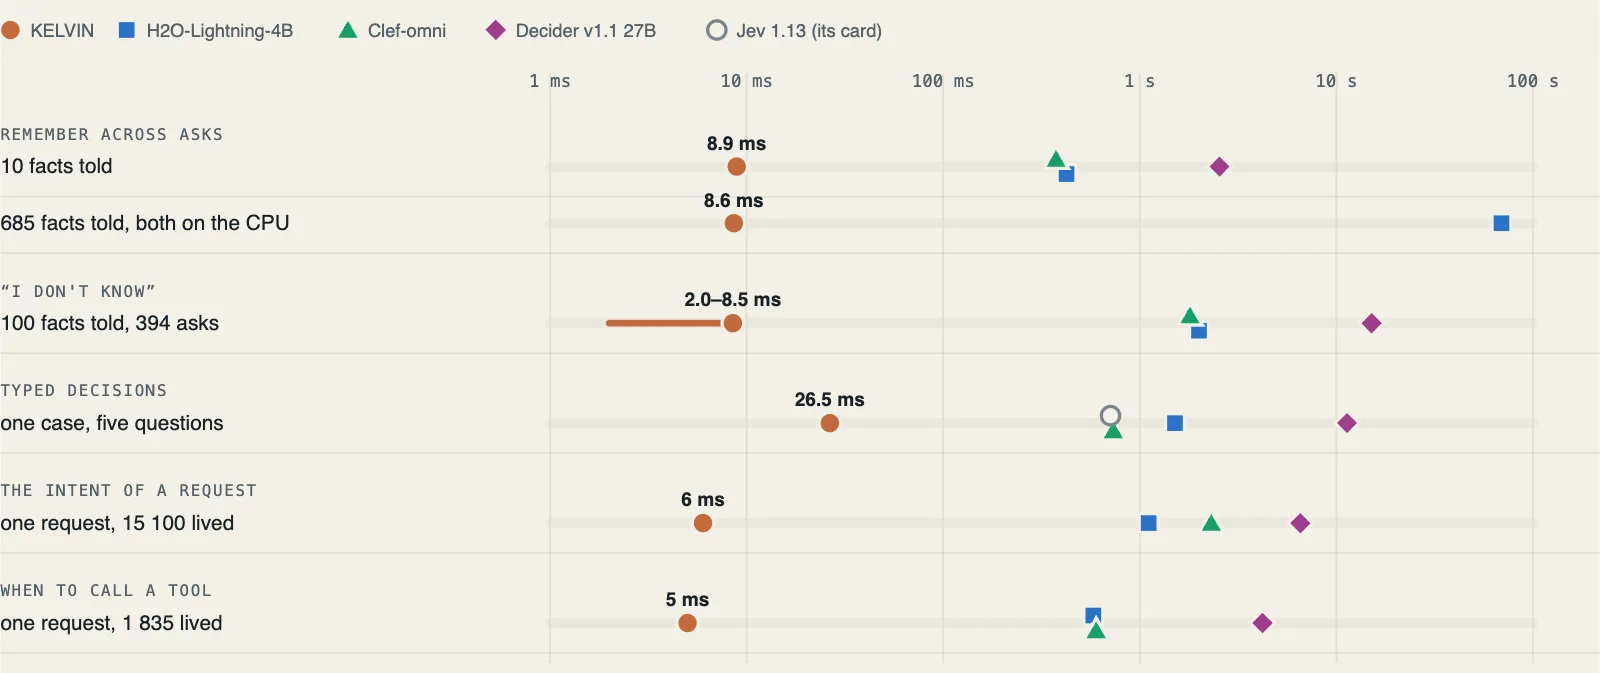
Aus dem eigenen Gedächtnis, auf einem Mac, ohne Netzwerk. Ein offenes Modell, dem alles mitgegeben wird: 424 ms bei zehn Fakten. Über die eigene Adresse: etwa 250 ms mit dem Netzwerk.
Falsche Antworten auf nie Gesagtes
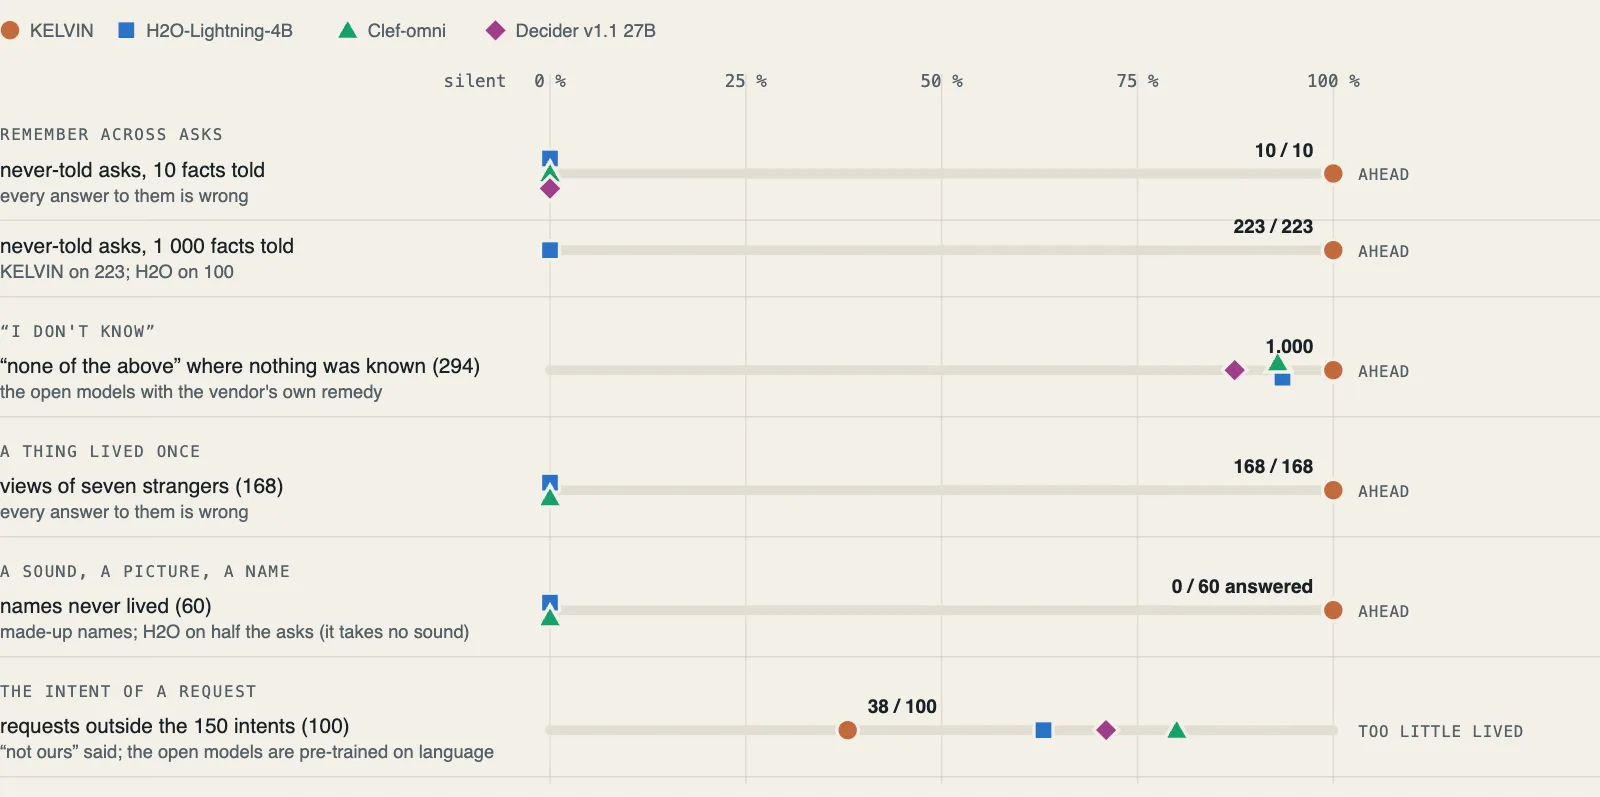
0
Still bei allen 223 Fragen, auf die es nie etwas gehört hat. Jedes offene Modell hat jede beantwortet, und jedes Mal falsch.
Grafikkarte
keine
KELVIN läuft allein auf dem Prozessor. Die offenen Modelle laufen auf der Grafikkarte.
Das ganze Programm
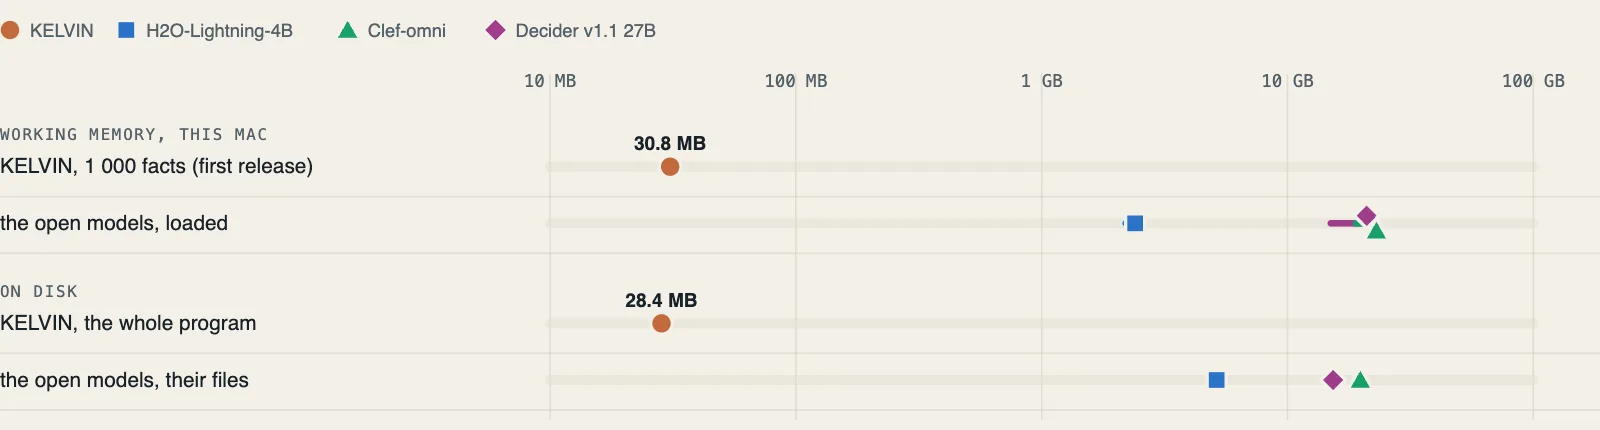
28,4 MB
KELVIN, wie unsere Server es betreiben. Die Dateien der offenen Modelle belegen 5,15 bis 19,78 GB.
Was mit einer Frage reist
die Frage
Ein offenes Modell braucht alles Gesagte in jeder Anfrage: 339 040 Tokens für 15 000 Absichten, mehr als jedes von ihnen fassen kann.
Jevs eigenes Feld
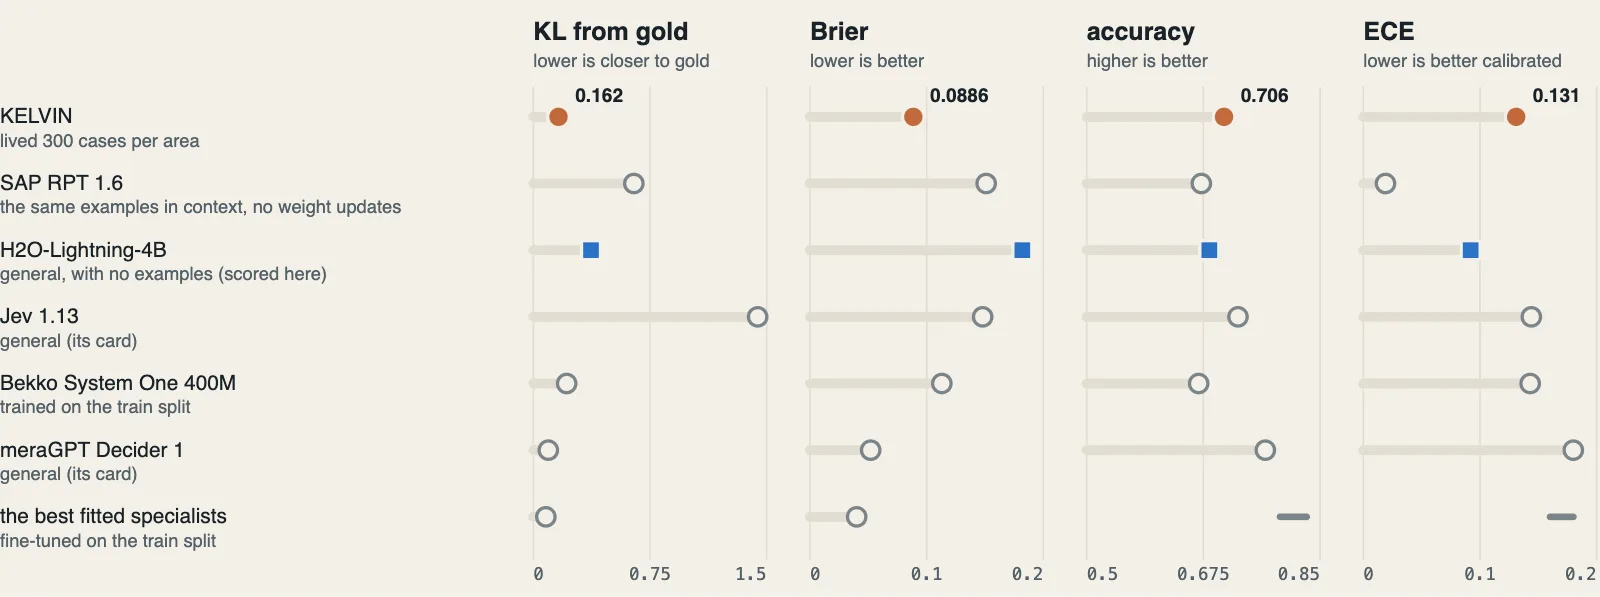
0,706
Typisierte Entscheidungen, nach dem Bewertungsprogramm des Datensatzes, ohne Training: vor H2O (0,684), SAP RPT 1.6 (0,672) und Bekko 400M (0,668). Unter Jevs eigener Angabe, 0,727.
Dieselben Fragen, dieselbe Maschine, Stufe für Stufe.
Drei offene Modelle von Jevs Art beantworteten dieselben Anfragen wie KELVIN, auf einem Mac. KELVIN hat die Beispiele jeder Aufgabe einmal erlebt; sie kamen vortrainiert.
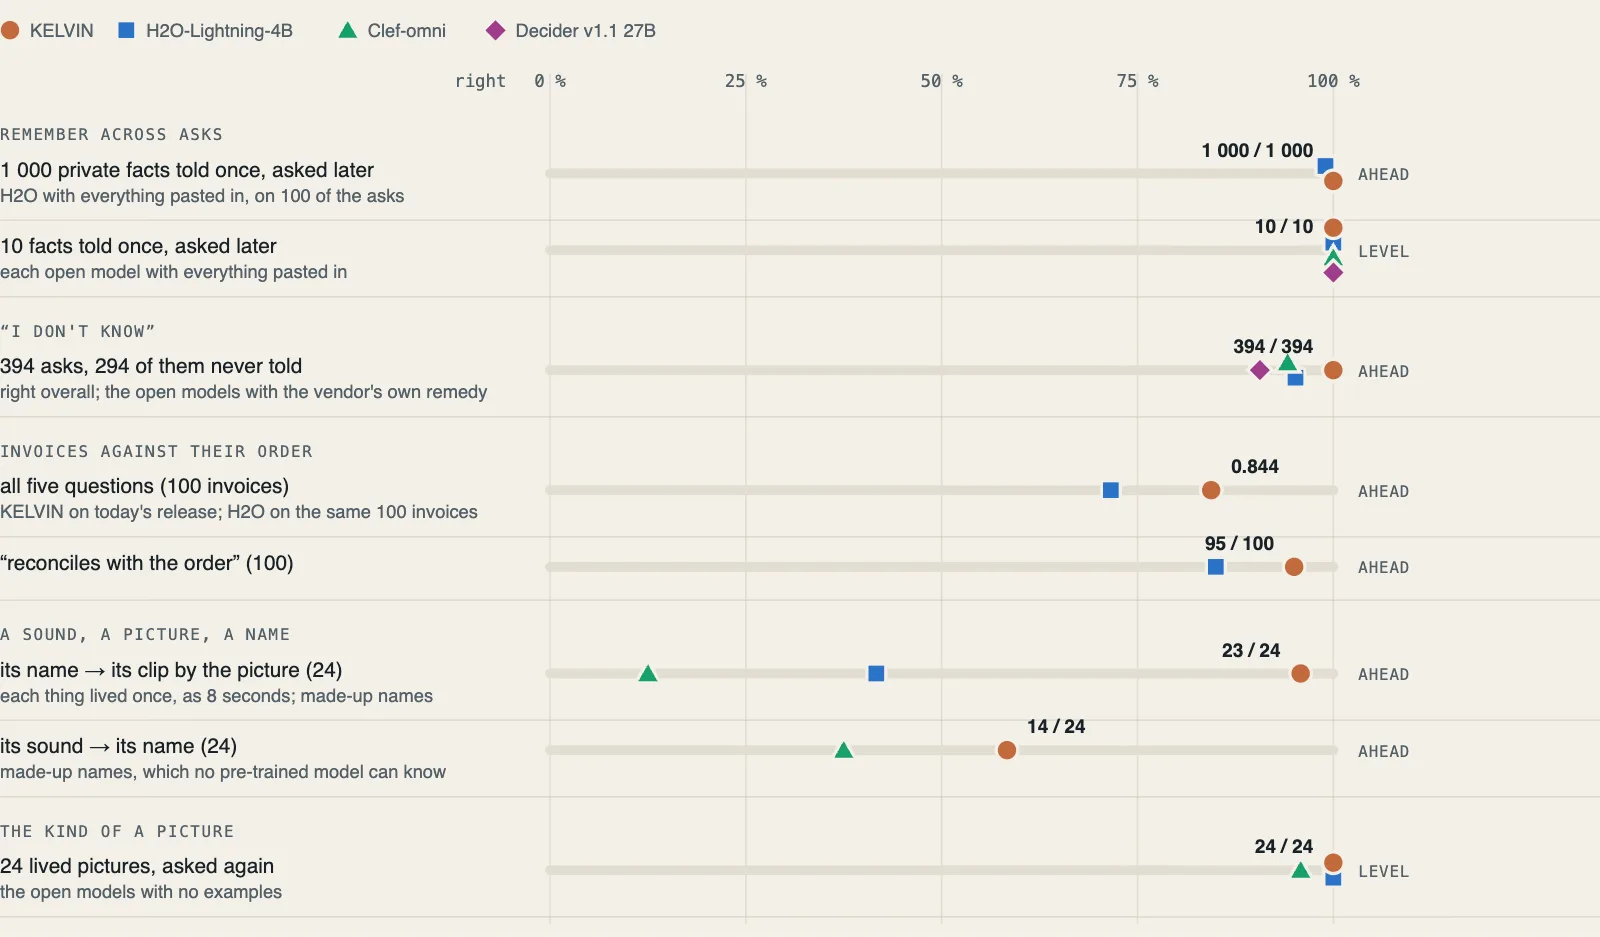
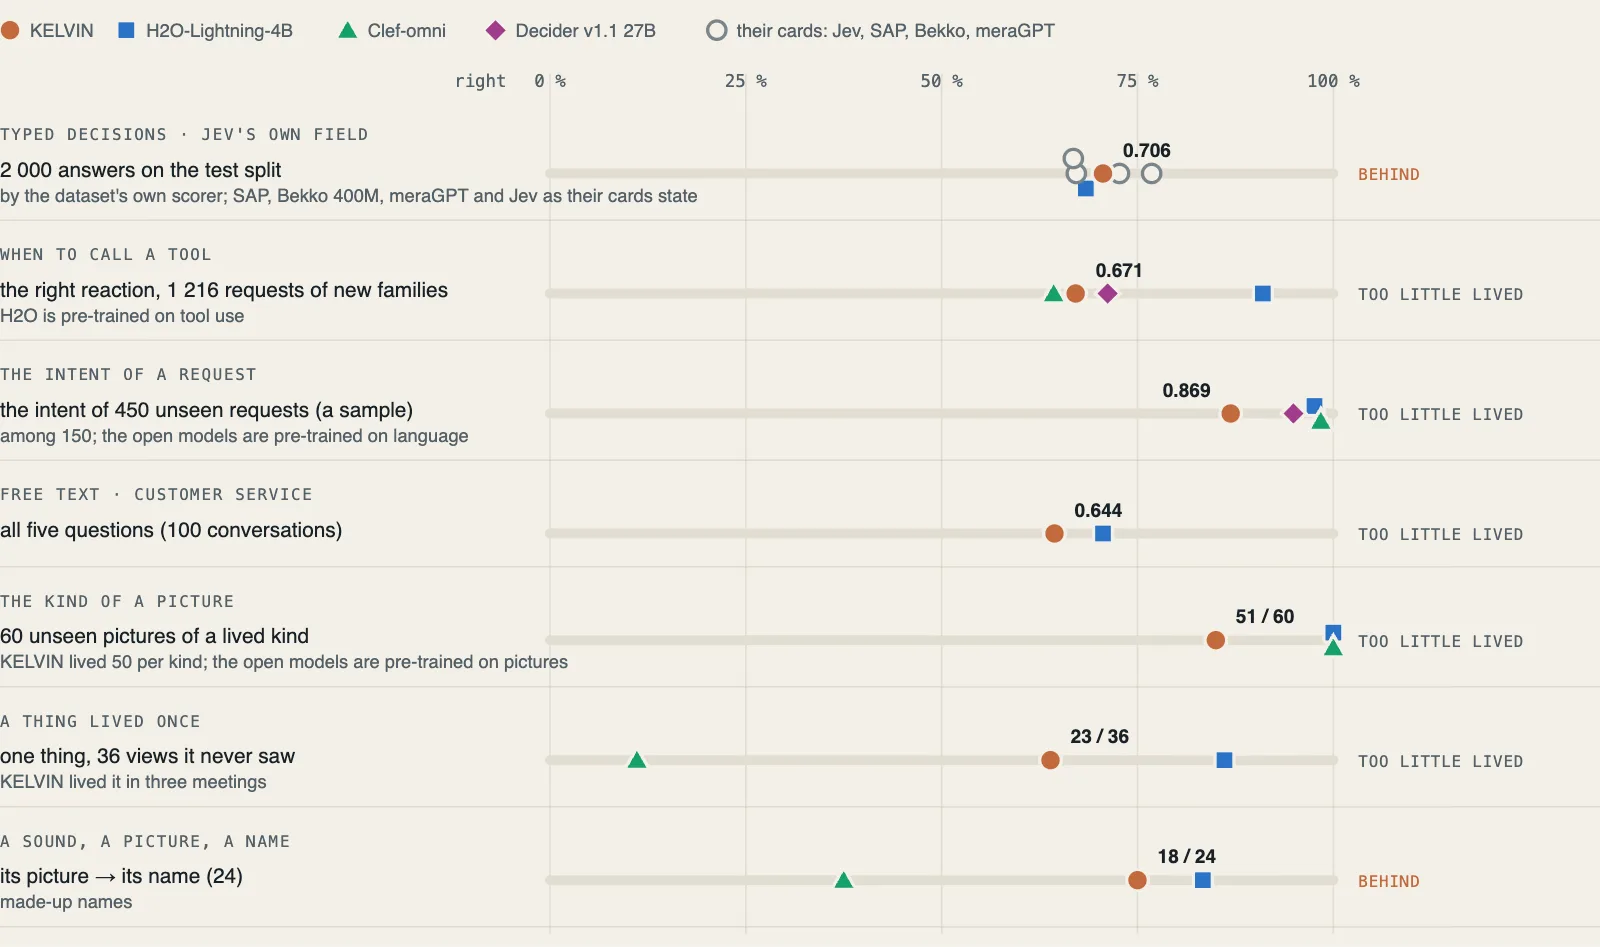
Richtig, oder still.
Wie sicher, nach dem Bewertungsprogramm des Datensatzes.
Es lernt nach dem Start, und behält es.
Ein vortrainiertes Modell steht fest, sobald es ausgeliefert ist. KELVIN lernt aus einer Erfahrung und behält sie.
1 000 / 1 000
Einmal gesagt, behalten
Private Fakten, die kein Training enthalten kann, später aus dem eigenen Gedächtnis beantwortet.
15 416 / 15 416
Übersteht einen Neustart
Über 32 Neustarts mitten im Lernen: jede Antwort Byte für Byte wie in einem ununterbrochenen Leben.
8 / 8
Nachweisbares Vergessen
Nach dem Vergessen sind die Gedächtnisdateien Byte für Byte die eines Gedächtnisses, das die Fälle nie erlebt hat; 800 / 800 Antworten gleich.
345 / 345
Ihr Gedächtnis gehört Ihnen
Ein anderes Gedächtnis, dem nichts gesagt wurde, bleibt bei jeder dieser Fragen still.
11,7 MB
15 000 Beispiele, behalten
Alles, was es für 150 Absichten erlebt hat, im eigenen Gedächtnis. Ein offenes Modell bräuchte es in jeder Anfrage.
216 / 216
Ein Name ist nur ein Name
Unter erfundenen Namen antwortet es genau wie unter echten. Kein vortrainiertes Modell kann diese Namen kennen.
Millisekunden auf dem Prozessor, gegen Sekunden auf der Grafikkarte.
Auf dem eigenen Server von KELVIN Meridian braucht KELVIN für eine Textfrage selbst 12,0 bis 30,5 ms; ein Leser wartet mit dem Netzwerk etwa 250 ms. Tausende Beispiele zu lernen dauert Sekunden bis Minuten, einmalig: 1 835 in 20,6 s, 15 100 in 156 s.
Sieben Tests. Ein Befehl je Test.
Die Daten und Kontrollen, die wir gegen den Dienst von KELVIN Meridian laufen ließen. Jede Anfrage und Antwort wird aufgezeichnet.
Die Tests, ihre Daten und ihre Kontrollen ↗
Test 6
345 / 345
Erinnern, was gesagt wurde
Einmal gesagte Fakten, in neuen Anfragen beantwortet. Ein anderes Gedächtnis: 345 / 345 still.
python3 tests/6-remember/run.pyTest 7
389 / 389
„Ich weiß es nicht“ sagen
Fragen, die es nicht wissen konnte, mit „keine davon“ beantwortet. Insgesamt richtig: 558 / 558.
python3 tests/7-i-dont-know/run.pyTest 1
0,706
Typisierte Entscheidungen aus Fällen
300 Fälle je Bereich als einzige Lehre. Mit vertauschten Antworten: 0,508.
python3 tests/1-typed-decisions/run.pyTest 4
0,849
Absicht, und „keine davon“
3 821 / 4 500 Absichten richtig benannt. Wo keine passt: 337 / 1 000.
python3 tests/4-intent/run.pyTest 2
50 / 60
Ein Bild: dieses, sonst seine Art
Ungesehene Bilder nach ihrer Art. Erlebte Bilder erneut: 24 / 24.
python3 tests/2-pictures/run.pyTest 3
23 / 24
Ein Klang, ein Ding und sein Name
Sein Clip nach dem Namen gewählt. Allein am Klang: 14 / 24.
python3 tests/3-sound-object-name/run.pyTest 5
0,671
Wann ein Werkzeug aufrufen
816 / 1 216 richtig. Mit vertauschten Reaktionen: 0,354.
python3 tests/5-when-to-call-a-tool/run.pyIhr Schlüssel. Ihr Gedächtnis.
- Zugang anfragen.
- Adresse und Schlüssel erhalten.
- Aus Ihrem eigenen Programm lehren und fragen.
curl https://<Ihre Adresse>/v1/systemone \
  -H "Authorization: Bearer $MERIDIAN_KEY" \
  -d @request.json