
Platziert, nicht gesucht: die Form eines Proteins aus seinen Kontakten
Lässt sich die gefaltete Form eines Proteins direkt aus einer Liste platzieren, welche seiner Teile einander berühren? Eine Messung an öffentlichen Proteinen, mit ihren Grenzen.
Methodennotiz
Die Frage
Wenn man weiß, welche Teile einer Proteinkette einander berühren: Lässt sich die ganze Kette dann auf einmal in ihre gefaltete Form bringen, ohne die unzähligen Arten zu durchsuchen, wie sie sich falten könnte?
Das Ergebnis
Nur mit der Angabe, welche Teile einer Proteinkette einander berühren, bringt unsere Engine die ganze Kette direkt in ihre gefaltete Form, ohne mögliche Formen zu durchsuchen. Weder Training noch eine Datenbank bekannter Strukturen gehen in die Methode ein.
Bei 157 verschiedenen Proteinen aus der öffentlichen Protein Data Bank, 46 bis 396 Aminosäuren lang, liegt die typische platzierte Form 4,26 Å von der gemessenen Struktur entfernt (der Median; ein Ångström, Å, ist ein Zehnmillionstel Millimeter). 45 % der Proteine kommen auf 4 Å heran, 76 % auf 6 Å.
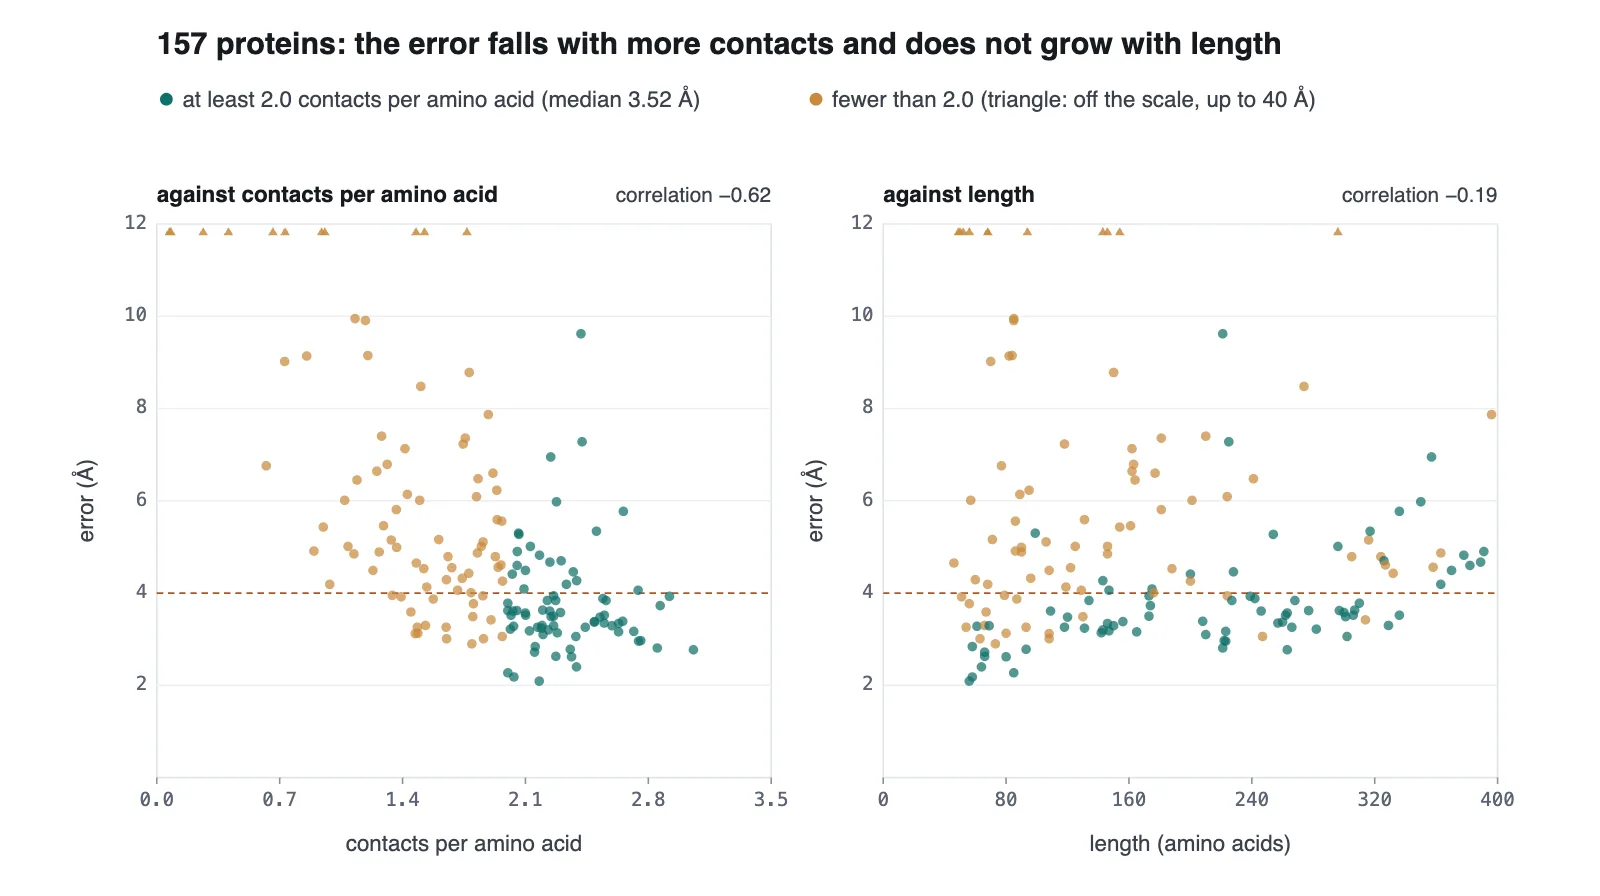
Der Fehler wächst nicht mit der Größe. In vier Größengruppen von je etwa 40 Proteinen, von den kürzesten Ketten bis zu den längsten, bleibt der Median des Fehlers zwischen 4,07 und 4,46 Å.
Was die Genauigkeit bestimmt, ist die Zahl der Kontakte. Bei den 75 Proteinen mit mindestens doppelt so vielen Kontakten wie Aminosäuren liegt der Median des Fehlers bei 3,52 Å, und 96 % kommen auf 6 Å heran.
Bekommt unsere Engine mehr als eine Liste von Kontakten, nämlich den gemessenen Abstand jedes Paars von Aminosäuren, die näher als 8 Å beieinanderliegen, baut sie dieselben 157 Proteine mit einem Median von 1,00 Å nach; 74 % kommen auf 2 Å heran.
Die Kontrolle
Eine Prüfung, dass die Form aus den Kontakten kommt: Wo eine Kette fast keine Kontakte hat, lässt sie sich nicht platzieren. Die beiden Ketten mit nur je 4 Kontakten liegen 28 und 40 Å daneben. Über alle 157 Proteine gilt: je weniger Kontakte pro Aminosäure, desto größer der Fehler.
Die Grenze
Die Kontakte stammen aus der gemessenen Struktur jedes Proteins: zwei Aminosäuren, die in der Kette mindestens fünf Plätze auseinanderliegen und deren Alpha-Kohlenstoffatome näher als 8 Å beieinanderliegen. Gemessen wird also allein das Platzieren. Es ist keine Vorhersage aus der Sequenz eines Proteins, und die Kontakte allein aus einer Sequenz vorherzusagen, löst diese Arbeit nicht.
Der Fehler ist der quadratisch gemittelte Abstand zwischen den platzierten und den gemessenen Alpha-Kohlenstoffatomen, eines pro Aminosäure, nachdem beide Formen übereinandergelegt wurden. Gezählt wird die bessere von platzierter Form und ihrem Spiegelbild, denn Kontakte allein legen nicht fest, in welche Richtung sich die Kette dreht.
Die Genauigkeit ist nicht gleichmäßig: 19 Proteine liegen mehr als 8 Å daneben, die meisten mit wenigen Kontakten für ihre Länge.
Die 1,00 Å stammen aus einer zweiten Messung, die die Abstände selbst bekommt; das ist mehr als das Wissen, welche Teile einander berühren.
Diese Prüfung ergibt sich aus den Daten, nicht aus einem eingebauten Fehler: Ein Lauf mit vertauschten oder zufälligen Kontakten wurde auf diesen 157 Proteinen nicht gemacht.
Die Engine findet die Form eines Proteins, das es schon gibt; ein neues Protein entwirft sie nicht. Mit anderen Methoden zur Proteinstruktur wird sie hier nicht verglichen.
Daten und Lizenz
Die Daten: 157 Proteinketten aus der Protein Data Bank (RCSB PDB), ausgewählt durch eine feste, im Skript festgelegte Abfrage: Röntgenstrukturen mit einer Auflösung von 2,0 Å oder besser, keine zwei mit mehr als 30 % gleicher Sequenz, gleichmäßig auf vier Größengruppen verteilt. Aus jedem Eintrag wurde das längste ununterbrochene Stück einer Kette verwendet.
Die Datendateien der Protein Data Bank sind unter der Gemeinfreiheitserklärung CC0 frei nutzbar.
Ansprechpartner
Fragen zu dieser Studie, oder ein ähnliches Problem in Ihrem Gebiet: Schreiben Sie uns.